2026-06-29
NLP 101 (3): O problema da memória
Uma das coisas mais frustrantes dos primeiros modelos de linguagem era que eles tinham memória de peixe dourado. Eles conseguiam olhar para palavras, encontrar padrões e capturar relações locais, mas frequentemente perdi
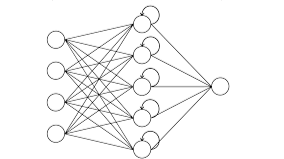
Uma das coisas mais frustrantes dos primeiros modelos de linguagem era que eles tinham memória de peixe dourado. Eles conseguiam olhar para palavras, encontrar padrões e capturar relações locais, mas frequentemente perdiam o começo da frase antes de chegar ao final.
E isso virou um grande problema para o NLP.
No artigo anterior, eu falei sobre Word2Vec e como ele transformou palavras em coordenadas matemáticas. Pela primeira vez, palavras parecidas podiam ficar próximas em um espaço vetorial. “rei”, “rainha”, “homem” e “mulher” deixavam de ser apenas textos e passavam a ocupar posições em uma geometria da linguagem.
Mas existia uma limitação importante, palavras isoladas não formam linguagem. Linguagem nasce da sequência. Pensa na frase:
“Artemísia publicou um artigo sobre NLP porque ela gosta muito da área.”
Nós sabemos que “ela” se refere a Artemísia, para uma máquina, isso exige memória.Ela precisa guardar uma informação que apareceu antes para interpretar uma palavra que apareceu depois. Foi aí que entram as Redes Neurais Recorrentes, as famosas RNNs.
Recurrent Neural Networks (RNN)
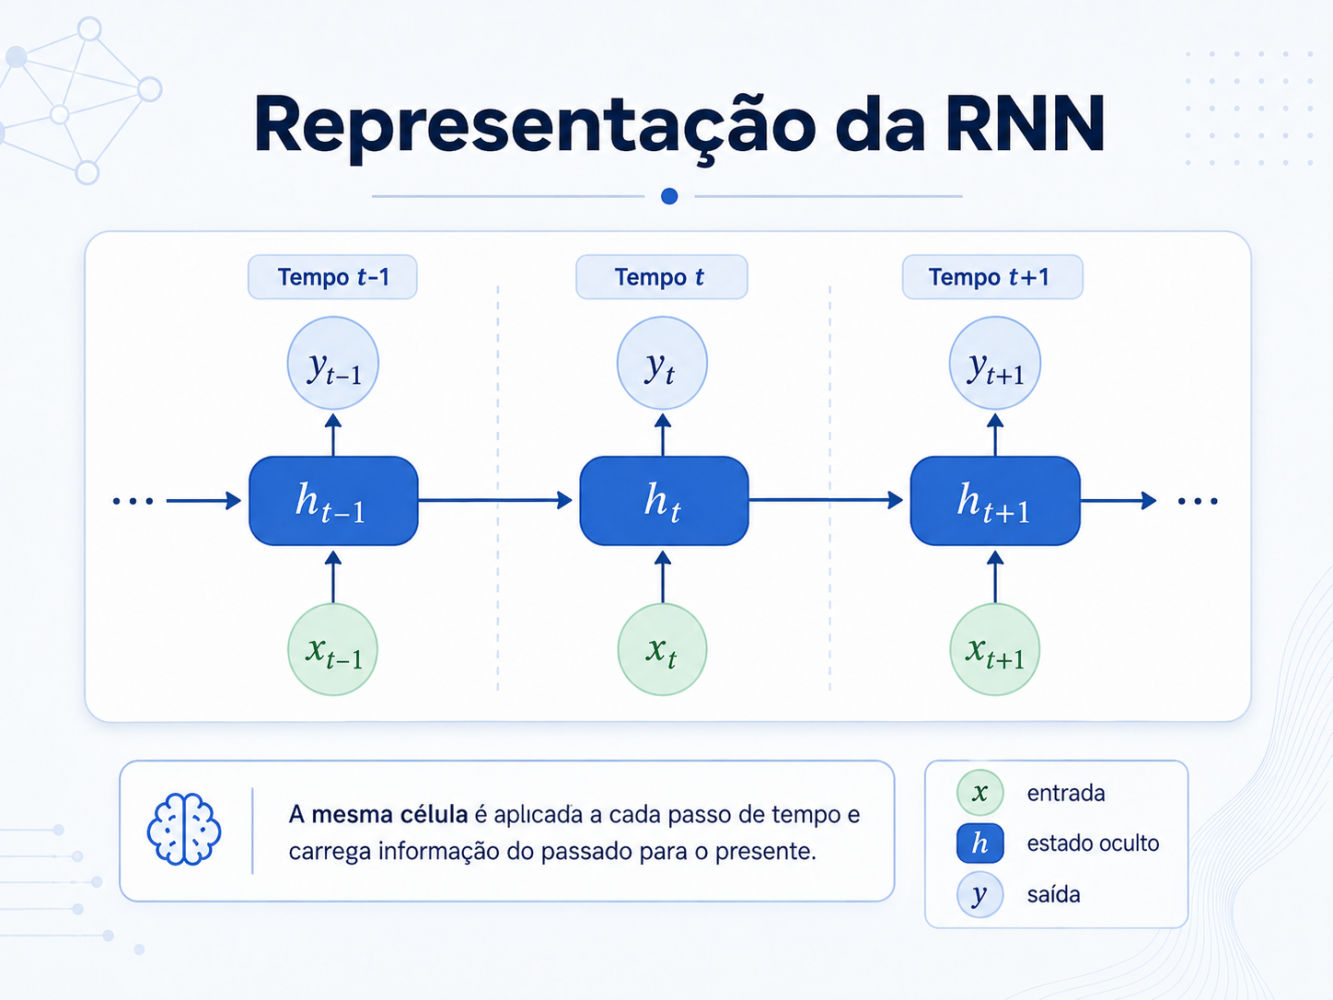
Em vez de processar cada palavra de forma totalmente separada, o modelo manteria um estado interno, uma espécie de memória resumida do que já havia sido lido. Matematicamente, uma RNN simples pode ser vista assim:
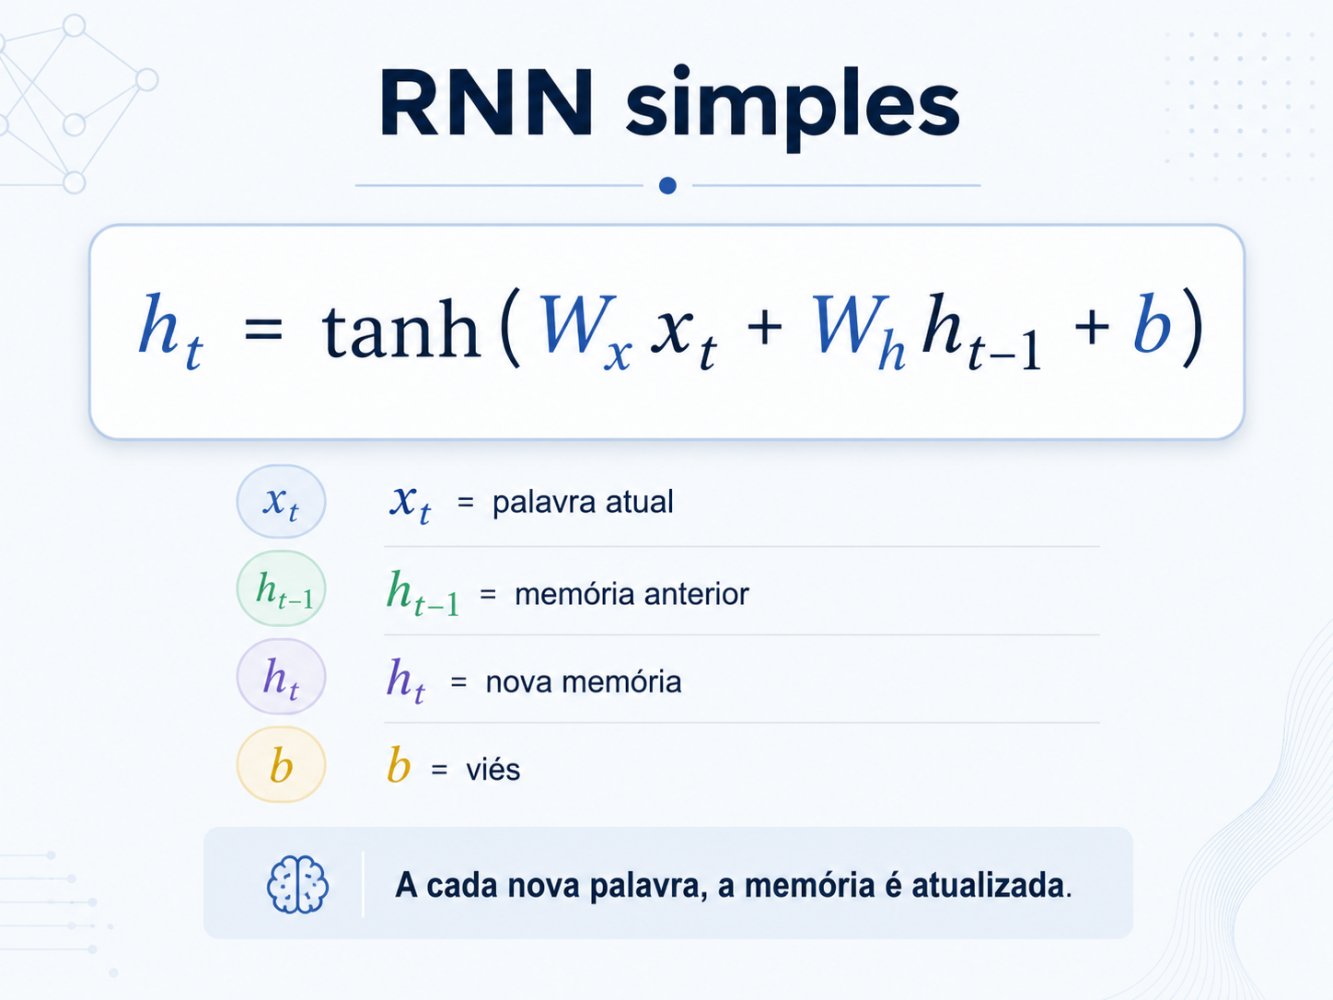
Ou seja, a cada nova palavra, o modelo atualiza aquilo que sabe sobre a frase. Isso foi um avanço enorme. Tradução automática, reconhecimento de fala, análise de sentimentos e várias outras aplicações melhoraram muito com esse tipo de arquitetura.O significado de uma palavra passou a depender do que veio antes.
Só que havia um problema, quanto maior a sequência, mais difícil ficava preservar informações antigas. A explicação matemática passa pelo gradiente. Durante o treinamento, o modelo ajusta seus pesos usando derivadas. Em uma sequência longa, essas derivadas vão sendo multiplicadas várias vezes ao longo do tempo.
De forma simplificada:
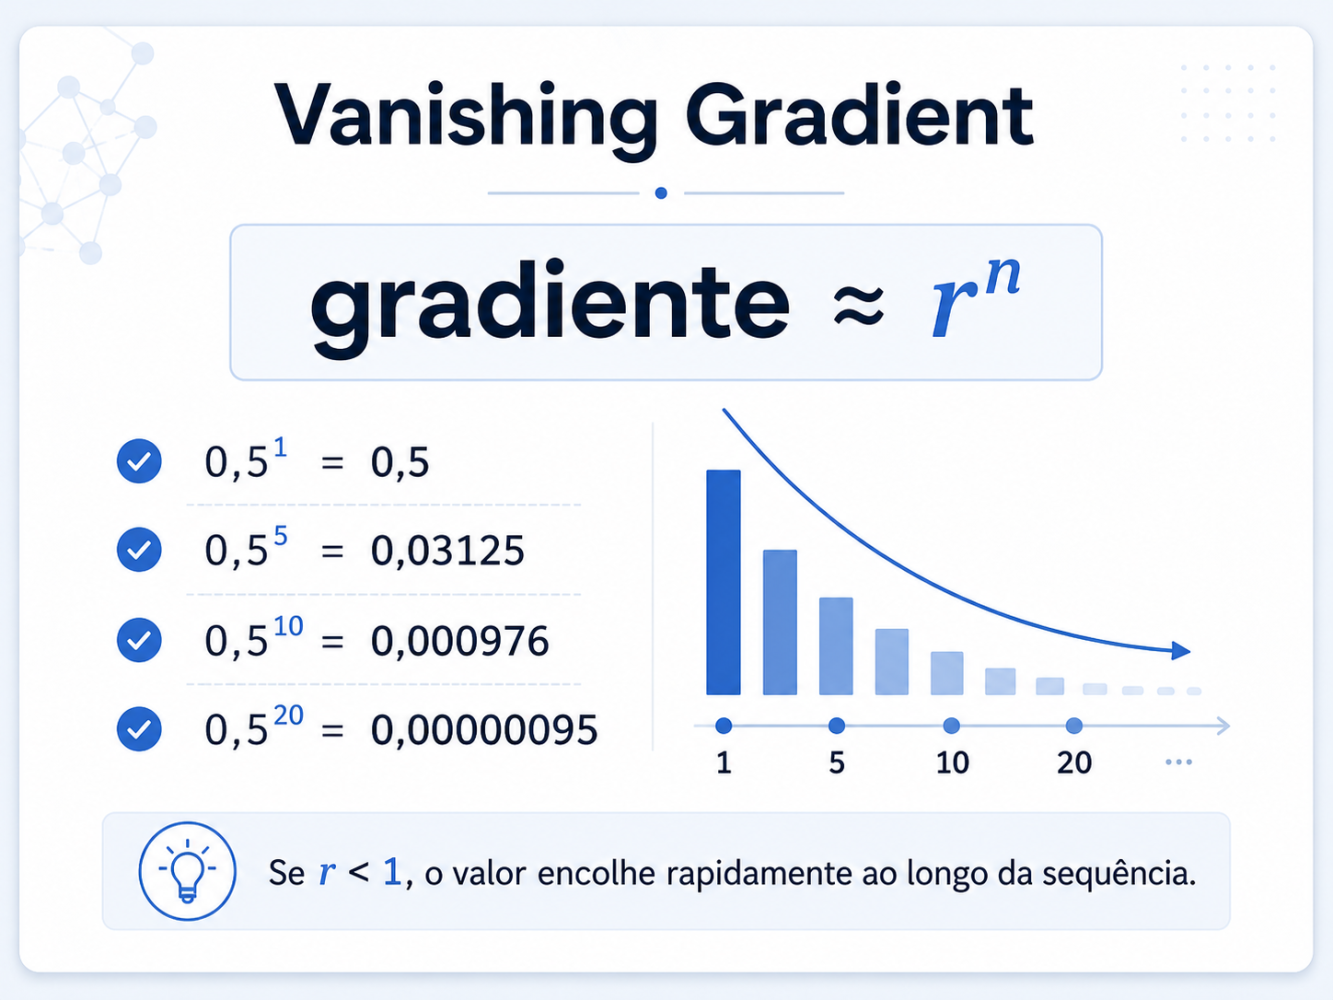
Se r for menor que 1, o valor diminui muito rápido. Por exemplo:
0,5^1 = 0,5 0,5^5 = 0,03125 0,5^10 = 0,000976 0,5^20 = 0,00000095
Agora imagina isso em uma frase longa.
A informação do começo ainda existe matematicamente, mas chega tão pequena no treinamento que quase não influencia mais o ajuste dos pesos. Esse é o famoso Vanishing Gradient, ou problema do gradiente desaparecendo. A intuição é parecida com tirar cópia de cópia de cópia. No começo ainda dá para ler. Depois de muitas cópias, os detalhes somem.
Long Short-Term Memory(LSTM)
Nas RNNs, a rede lembrava bem do passado recente, mas tinha dificuldade para preservar eventos distantes. Foi então que surgiram as LSTMs, Long Short-Term Memory.
O nome já entrega a ideia: criar uma memória capaz de lidar melhor com dependências curtas e longas. As LSTMs introduziram mecanismos chamados gates, ou portões.
Eles ajudam a decidir:
O que guardar. O que esquecer. O que usar naquele momento, de forma simplificada, uma LSTM funciona como uma memória com filtros. Algumas informações pass outras são descartadas, algumas ficam preservadas por mais tempo.Isso ajudou muito em frases como:
“O livro que comprei na feira científica da universidade no ano passado era excelente.”
Para entender quem era excelente, o modelo precisa lembrar de “livro”, mesmo depois de várias palavras no meio do caminho. As LSTMs melhoraram bastante essa capacidade e dominaram o NLP durante vários anos.
Depois vieram as GRUs, Gated Recurrent Units. A ideia era parecida com a das LSTMs, mas com uma arquitetura mais simples. Menos componentes,menos parâmetros gerava treinamento mais eficiente.
Durante muito tempo, RNNs, LSTMs e GRUs foram consideradas o estado da arte para várias tarefas de linguagem, mas ainda existiam dois limites importantes.
Primeiro: esses modelos liam a sequência palavra por palavra.
Segundo: quanto maior o contexto, mais difícil ficava carregar tudo em uma memória comprimida.
É como tentar resumir um livro inteiro em uma única anotação de rodapé, alguma coisa importante vai escapar.então os pesquisadores começaram a fazer uma pergunta diferente.
Em vez de obrigar o modelo a carregar tudo em uma memória comprimida, e se ele pudesse olhar diretamente para as partes relevantes da frase? Essa pergunta abriu caminho para uma das ideias mais importantes da história da Inteligência Artificial moderna:
Attention.
E é aí que a nossa história continua.
No próximo post da série NLP 101, vamos falar sobre como a Attention mudou a forma como modelos de linguagem lidam com contexto.
Gostou? Comenta aqui.
Postagem original no LinkedIn: NLP 101 (3): O problema da memória
Comentários
A conversa ainda não começou.