2026-02-17
O que é um gradiente, formalmente?
O conceito de gradiente surge no cálculo diferencial aplicado a funções de múltiplas variáveis [1]. Ele descreve como uma função varia localmente em relação às suas variáveis.
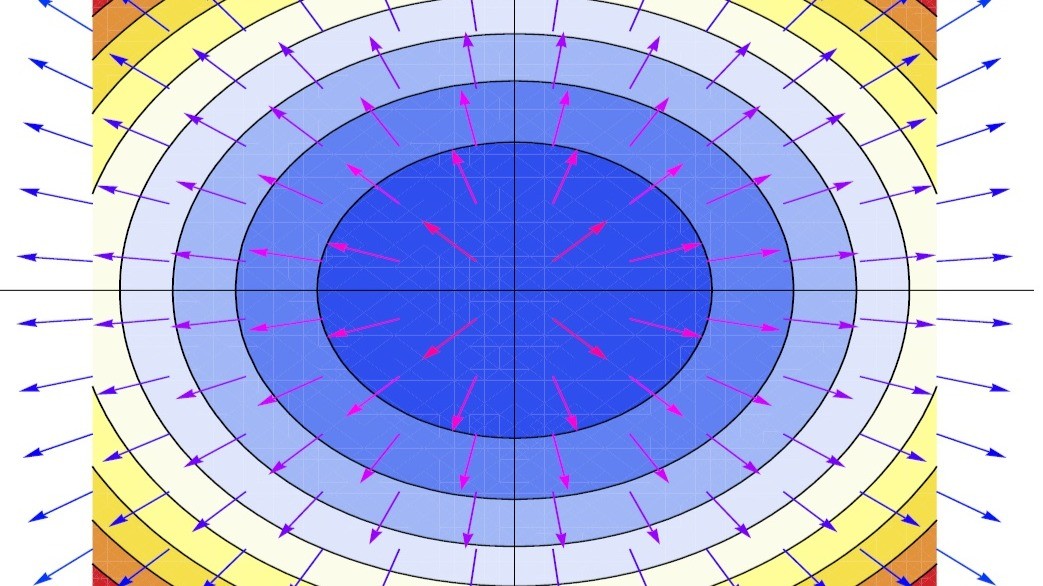
O conceito de gradiente surge no cálculo diferencial aplicado a funções de múltiplas variáveis [1]. Ele descreve como uma função varia localmente em relação às suas variáveis.
Considere uma função escalar diferenciável:
\[f:\mathbb{R}^{n}\to\mathbb{R}\]
Isso significa que a função recebe um vetor de dimensão n e retorna um número real.
Se f depende de várias variáveis, podemos calcular suas derivadas parciais:
\[\frac{\partial f}{\partial x_1},\frac{\partial f}{\partial x_2},\ldots,\frac{\partial f}{\partial x_n}\]
O gradiente é o vetor formado por todas essas derivadas:
\[\nabla f(x)=\left(\frac{\partial f}{\partial x_1},\frac{\partial f}{\partial x_2},\ldots,\frac{\partial f}{\partial x_n}\right)\]
Ele organiza, em forma vetorial, como a função varia em cada direção possível no espaço das variáveis.
Interpretação geométrica
O gradiente aponta na direção de maior crescimento local da função.
Seu módulo indica a taxa máxima de variação naquele ponto [1].
A derivada direcional na direção de um vetor unitário v é dada por:
\[D_{v}f(x)=\nabla f(x)\cdot v\]
Isso significa que o vetor ∇f(x) concentra a informação sobre variações locais da função.
Além disso, o gradiente é perpendicular às superfícies de nível da função, isto é, aos conjuntos onde f(x) permanece constante.
Aproximação local
Para pequenos deslocamentos Δx, podemos escrever:
\[f(x+\Delta x)\approx f(x)+\nabla f(x)\cdot\Delta x\]
Essa aproximação linear fundamenta métodos iterativos de otimização [2].
Relação com otimização
Em problemas de minimização, buscamos pontos onde:
\[\nabla f(x)=0\]
Quando a solução analítica não está disponível, utilizamos um procedimento iterativo:
\[x^{(t+1)}=x^{(t)}-\eta\nabla f\!\left(x^{(t)}\right)\]
onde η > 0 é a taxa de aprendizado, parâmetro que controla o tamanho do passo em cada atualização [2].
Conexão com Machine Learning
Em aprendizado de máquina, a função f torna-se a função de perda L(θ).
O treinamento consiste em resolver:
\[\theta^{*}=\arg\min_{\theta} L(\theta)\]
O gradiente ∇L(θ) mede como pequenas variações nos parâmetros alteram o erro.
A descida do gradiente utiliza essa informação para atualizar iterativamente os parâmetros e reduzir o erro [3].
Em redes neurais profundas, a retropropagação calcula ∇L(θ) de forma eficiente aplicando a regra da cadeia do cálculo diferencial [4].
Conclusões
O gradiente é um operador diferencial que conecta cálculo, geometria e otimização.
No contexto de aprendizado de máquina, ele formaliza a relação entre erro e atualização de parâmetros.
Compreender ∇f permite interpretar com maior precisão como modelos ajustam seus parâmetros e como o processo de treinamento evolui ao longo das iterações.
Referências
[1] T. M. Apostol, Calculus, Vol. II. Wiley, 1969.
2] S. Boyd and L. Vandenberghe, Convex Optimization. Cambridge University Press, 2004.
[3] T. M. Mitchell, Machine Learning. McGraw-Hill, 1997.
[4] D. E. Rumelhart, G. E. Hinton, and R. J. Williams, “Learning representations by back-propagating errors,” Nature, 1986.
Postagem original no LinkedIn: O que é um gradiente, formalmente?
Comentários
A conversa ainda não começou.